Anketlerde Sahtekârlık Değişti: Artık “Gerçek İnsan” Olmak Yetmiyor
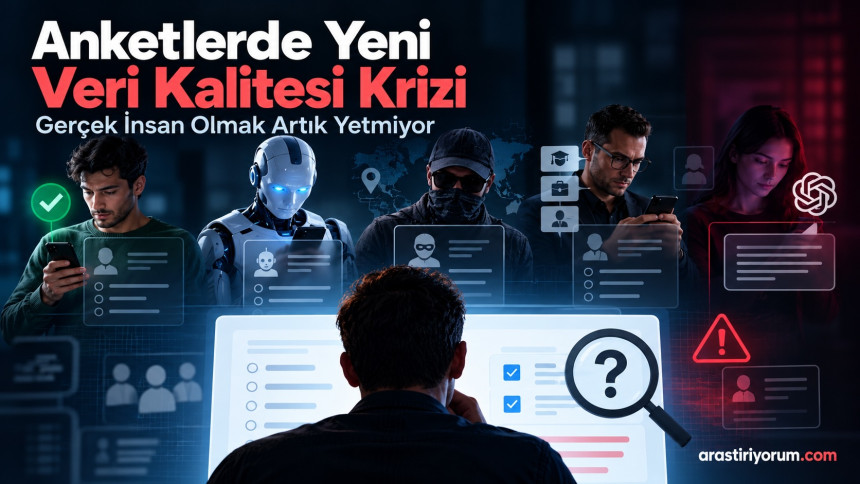
Online araştırmalarda veri kalitesi sorunu artık yalnızca botları yakalamaktan ibaret değil. Profesyonel katılımcılar, yapay zekâ destekli yanıtlar, konum manipülasyonu ve düşük kaliteli gerçek kullanıcılar araştırmacıları daha zor bir soruyla karşı karşıya bırakıyor: Bir yanıtın güvenilir olduğuna nasıl karar vereceğiz?
Online araştırmaların veri kalitesi tartışması uzun süre oldukça basit bir çerçevede yürüdü.
Botları engelle.
Aynı kişinin birden fazla kez ankete girmesini önle.
Çok hızlı cevaplayanları çıkar.
Tutarsız yanıtları temizle.
Fakat 2026'da bu yaklaşım giderek yetersiz kalıyor.
Çünkü araştırmacının karşısındaki problem artık yalnızca otomasyon değil. Gerçek bir insan da araştırmayı yanıltabiliyor. Üstelik bunu bazen bilinçli olarak, bazen teşvik sisteminin yarattığı davranışlarla, bazen de onlarca hatta yüzlerce ankete katılmanın getirdiği profesyonelleşmeyle yapıyor.
Dolayısıyla benim asıl dikkatimi çeken değişim şu:
Araştırmada “insan mı, bot mu?” ayrımı giderek önemini kaybediyor. Yerini “bu katılımcının ürettiği veri araştırma açısından güvenilir mi?” sorusu alıyor.
Sorun düşündüğümüzden daha büyük
Insights Association'ın veri kalitesi çalışmalarında sektör profesyonellerinin %63'ü araştırma projelerinde belirli ölçüde sahtekârlığın artık kaçınılmaz olduğunu düşünüyor. %64'ü fraud nedeniyle proje gecikmesi veya başka bir olumsuzluk yaşadığını, %56'sı ise veri sahtekârlığının alınan kararları etkilediğini bildiriyor.
2026'nın ilk yarısına ilişkin Global Data Quality Benchmarking çalışması da problemin özellikle zor hedef kitlelerde devam ettiğini gösteriyor.
Araştırma ajanslarının bildirdiği pre-survey ve in-survey çıkarma oranı küresel ölçekte %28,5 düzeyinde. Sample sağlayıcılarında bu oran %21,2. B2B araştırmaları ise hem araştırma öncesinde hem saha sırasında hem de sonrasındaki veri temizliğinde en problemli alan olmaya devam ediyor.
Bu rakamları yalnızca “anketlerin dörtte biri sahte” şeklinde okumak doğru olmaz.
Ancak önemli bir şeyi açıkça gösteriyor:
Veri kalitesi artık araştırma bittikten sonra yapılan küçük bir temizlik işlemi değil, araştırma tasarımının kendisinin bir parçası.
Fraud artık tek bir davranış değil
Bugün araştırma sistemini manipüle etmeye çalışan kişileri aynı kategoriye koymak oldukça yanıltıcı.
Örneğin bir katılımcı gerçekte sahip olmadığı bir mesleği veya niteliği söyleyerek yüksek teşvikli bir B2B araştırmasına girmeye çalışabilir.
Başka biri onlarca farklı araştırma paneline kayıtlı olabilir ve anketlerin eleme mantığını ezberlemiş olabilir.
Bir başkası VPN ya da residential proxy kullanarak bulunduğu ülkeyi değiştirebilir.
Bir başkası gerçek bir insan olmasına rağmen açık uçlu soruları ChatGPT benzeri bir sistemle yanıtlayabilir.
Bir diğeri ise hiçbir teknolojik hile kullanmadan soruları düşünmeden işaretleyebilir.
Teknik olarak bunların hepsi aynı şey değil.
Fakat araştırma açısından ortak sonuçları var:
Ölçmeye çalıştığımız gerçekliğin yerine başka bir gerçeklik üretmeye başlıyorlar.
GreenBook'ta yayımlanan güncel bir değerlendirmede de benzer biçimde sahtekârlığın artık tek bir kategori olarak ele alınamayacağı savunuluyor. Makalede konum sahteciliği, yapay cihaz özellikleri, proxy/VPN kullanımı ve profesyonel anket davranışı gibi farklı örnekler gösteriliyor.
Buradaki önemli nokta teknoloji değil.
Niyet ve davranışın ayrıştırılması.
Gerçek insan olmak artık kalite garantisi değil
Bence araştırma sektörü açısından en zor kabul edilmesi gereken nokta bu.
Bir katılımcı tamamen gerçek olabilir.
Gerçek bir telefonu olabilir.
Gerçek IP adresi kullanabilir.
CAPTCHA'yı geçebilir.
Doğru ülkede yaşayabilir.
Ama yine de kötü veri üretebilir.
Özellikle “professional respondent” dediğimiz çok yoğun anket katılımcılarında bu problem yıllardır biliniyor. ESOMAR'ın online sample kalite rehberi de profesyonel katılımcılar, dikkatsiz yanıtlar, duplicate katılım ve temsil sorunlarını yıllardır temel riskler arasında değerlendiriyor.
Burada araştırmacı açısından oldukça rahatsız edici bir durum ortaya çıkıyor:
Kimlik doğrulama ile veri doğrulama aynı şey değil.
Bir kişinin kim olduğunu doğrulayabilirsiniz.
Ama verdiği cevabın gerçekten düşündüğü şeyi temsil edip etmediğini aynı kolaylıkla doğrulayamazsınız.
Bir başka problem: Nadir gruplar
Fraud'un araştırma sonuçlarını en fazla bozduğu yerlerden biri de düşük insidanslı hedef kitleler.
Çünkü teşvik sistemi katılımcıya şu mesajı veriyor:
“Bu gruba girersen ankete kabul edilirsin.”
Ve bazı insanlar doğal olarak sistemin ne duymak istediğini öğreniyor.
Pew Research Center'ın bogus respondent çalışmaları bunun ciddi sonuçları olabileceğini gösteriyor. Özellikle nadir tutum ve davranışların ölçüldüğü araştırmalarda sahte veya düşük kaliteli yanıtlar büyük hata yaratabiliyor.
Pew'in 2023 benchmarking çalışmasında bogus respondent kaynaklı hata, genç ve Hispanik katılımcılarda genel nüfusa göre yaklaşık iki kat daha yüksek ölçülmüş. Araştırmacılar bunun nedenlerinden birinin bu grupların araştırmalarda daha fazla aranması olabileceğine dikkat çekiyor.
Bunun B2B araştırmalarına uyarlanması zor değil.
Bir ankette CIO aranıyorsa bir anda çok sayıda CIO ortaya çıkabiliyor.
Kardiyolog aranıyorsa katılımcı kardiyolog olmayı öğreniyor.
İnsan davranışı teşvik sistemlerine uyum sağlıyor. Ekonomi kitaplarında bunun daha zarif isimleri var, ama sonuç değişmiyor.
Yapay zekâ işleri daha da karıştırıyor
Eskiden kötü bir açık uçlu yanıtı görmek çoğu zaman kolaydı.
Anlamsızdı.
Soruyla ilgisizdi.
Kopyalanmıştı.
Dilbilgisi kötüydü.
Generatif yapay zekâ bu göstergelerin çoğunu ortadan kaldırdı.
Bugün kötü niyetli veya dikkatsiz bir katılımcı birkaç saniye içinde son derece düzgün, anlamlı ve bağlama uygun bir açık uçlu cevap üretebiliyor.
Bu nedenle sadece cevabın kalitesine bakmak giderek tehlikeli hale geliyor.
GreenBook'taki başka bir saha örneğinde, oldukça düzgün ve konuya uygun açık uçlu cevapların bazıları için sistemin hiçbir klavye girdisi kaydetmediği görülmüş. Tek başına bunun fraud kanıtı olmadığı özellikle belirtiliyor, fakat davranışsal sinyallerle cevap içeriğinin birlikte değerlendirilmesi gerektiğini güzel biçimde gösteriyor.
Dolayısıyla geleceğin kalite kontrolü muhtemelen yalnızca ne söylendiğine değil, cevabın nasıl üretildiğine de bakacak.
Sentetik katılımcılar çözüm mü?
Fraud problemi büyüdükçe ilginç bir fikir de yaygınlaşıyor:
“Madem insan katılımcılar bu kadar problemli, gerçek insanların yerine yapay zekâ kullansak?”
2026'da Pew Research Center tam olarak bunu test etti.
Gerçek American Trends Panel katılımcılarının profilleri kullanılarak yapay zekâ modellerinden aynı anket sorularını cevaplamaları istendi.
Sonuç pek cesaret verici değil.
Araştırmacılar sentetik katılımcıların kamuoyunun genel ruh halini güvenilir biçimde tahmin edemediğini, bazı demografik gruplarda hatanın daha da arttığını buldu.
Özellikle güncel olaylar ve zamana duyarlı sorular sentetik örneklemler için daha problemli.
Bu benim için önemli bir ayrım.
Yapay zekâ araştırmanın pek çok bölümünü hızlandırabilir.
Anket tasarlayabilir.
Kodlama yapabilir.
Açık uçlu yanıtları sınıflandırabilir.
Veri analizinde yardımcı olabilir.
Ama insanların ne düşündüğünü öğrenmenin en güvenilir yolu hâlâ insanlara sormak.
Sorun insanlardan vazgeçmek değil, doğru insanlardan güvenilir veri toplayabilmek.
Tek bir fraud skoru yeterli olmayabilir
Bundan sonra veri kalitesinde daha fazla göreceğimizi düşündüğüm yaklaşım “layered validation”, yani katmanlı doğrulama.
Bir araştırmaya yalnızca IP kontrolü koymak artık yeterli değil.
Ben bunu kabaca dört katman olarak düşünüyorum.
Kimlik ve erişim katmanı:
Aynı kişinin birden fazla hesapla katılmasını, yanlış ülke veya hedef gruptan girişleri azaltmaya çalışıyor.
Cihaz ve ağ katmanı:
VPN, proxy, device fingerprinting ve olağandışı cihaz kombinasyonlarını inceliyor.
Davranış katmanı:
Yanıt süresi, mouse ve klavye davranışı, ekran geçişleri, tekrar eden örüntüler gibi sinyalleri değerlendiriyor.
Cevap katmanı:
Tutarlılık, açık uçlu yanıtların niteliği, straight-lining ve diğer veri anomalilerini inceliyor.
Bunların hiçbiri tek başına kesin kanıt değil.
Asıl değerleri birlikte kullanıldıklarında ortaya çıkıyor.
Nitekim ESOMAR da katılımcı doğrulama, fraud önleme, engagement kontrolü, örneklem seçimi ve metodolojik şeffaflığı online sample kalitesinin ayrı fakat birbirini tamamlayan parçaları olarak tanımlıyor.
Fakat fazla agresif temizlik de veri kalitesini bozabilir
Burada başka bir tuzak var.
Fraud korkusuyla mümkün olduğunca fazla katılımcıyı elemek de doğru değil.
Gerçek kullanıcıların VPN kullanması mümkün.
Privacy-first browser kullanmaları mümkün.
Kurumsal ağlardan bağlanmaları mümkün.
Tarayıcı güvenlik ayarlarını değiştirmeleri mümkün.
Dolayısıyla tek bir sinyali “fraud” olarak yorumlamak gerçek katılımcıları yanlışlıkla veri setinden çıkartabilir.
Insights Association da bu nedenle fraud tespitinde aşırı agresif filtrelemenin geçerli katılımcıları dışlayabileceğini, örneklemi bozabileceğini ve araştırma sonuçlarında bias yaratabileceğini özellikle vurguluyor.
Bu, siber güvenlik dünyasında çok iyi bildiğimiz false positive problemine oldukça benziyor.
Bir güvenlik sistemi her şeyi engellerse saldırıyı da engeller.
Ama bir noktadan sonra sistemi kullanacak insan da kalmaz.
Araştırmada da durum farklı değil.
Siber güvenlikten alınabilecek bir ders var
Bu konuya biraz da yıllardır siber güvenlik tarafında çalışan biri olarak baktığımda oldukça tanıdık geliyor.
Siber güvenlikte artık “kötü trafik” diye tek bir kategori kullanmıyoruz.
Phishing başka bir şey.
Credential theft başka.
Malware başka.
Insider threat başka.
Ransomware başka.
Her birinin davranışı, göstergeleri ve savunması farklı.
Online araştırma da aynı evreye geliyor.
“Fraudulent respondent” etiketi fazla kaba kalmaya başladı.
Asıl sorular şunlar olmalı:
Bu katılımcıda hangi davranış şüpheliydi?
Hangi kontrol bunu tespit etti?
Başka hangi sinyaller bunu destekliyor?
Bu kişi araştırmaya hiç girmemeli miydi, yoksa yanıtları daha sonra mı sorunlu hale geldi?
Temizleme kararı sonuçları ne kadar değiştirdi?
Bu yaklaşım aynı zamanda kalite kontrolünü bir “black box” olmaktan çıkarıyor.
Araştırmacı açısından asıl değişim burada
Bence araştırma sektörünün bundan sonraki veri kalitesi tartışması “hangi fraud detection aracını kullanalım?” sorusuna sıkışmamalı.
Daha önemli konu kalitenin nasıl ölçüldüğü ve açıklanabildiği.
Örneğin bir araştırmanın sonunda yalnızca “1.000 geçerli görüşme elde ettik” demek yerine şunları da bilmek giderek daha değerli hale geliyor:
Kaç kişi araştırmaya girmeden elendi?
Kaç görüşme saha sırasında kalite kontrollerine takıldı?
Kaçı saha sonrasında temizlendi?
Hangi kalite kontrolleri kullanıldı?
Temizleme öncesi ve sonrası sonuçlar ne kadar değişti?
Katılımcılar hangi kaynaklardan geldi?
Insights Association'ın Ağustos 2026'da yayımladığı Sample Supply Transparency Framework de tam olarak bu soruna odaklanıyor. Panel, exchange, aggregator, router ve programmatic kaynakların birbirine karıştığı günümüz sample zincirinde katılımcının araştırmaya nereden ve nasıl geldiğinin görünür hale getirilmesini öneriyor.
Bence bu önemli.
Çünkü veri kalitesi yalnızca katılımcının problemi değil.
Sample sağlayıcının, araştırma şirketinin, platformun ve araştırma tasarımının ortak sorumluluğu.
Benim çıkardığım sonuç
Online araştırmada fraud bitmeyecek.
Muhtemelen daha da sofistike hale gelecek.
Ancak mesele artık daha güçlü bir bot filtresi satın almak değil.
Araştırmacının kaliteyi tek bir skor yerine birbirini tamamlayan sinyaller üzerinden değerlendirmesi gerekiyor.
Ve belki daha da önemlisi, kalite kontrollerinin de araştırma metodolojisinin bir parçası olarak raporlanması gerekiyor.
Çünkü bundan sonra güvenilir araştırmayı diğerinden ayıracak şey yalnızca örneklem büyüklüğü olmayabilir.
Verinin nereden geldiğini, nasıl doğrulandığını ve hangi kararlarla temizlendiğini açıklayabilmek de araştırmanın kendisi kadar önemli hale geliyor.
Eskiden temel soru şuydu:
“Katılımcı gerçek mi?”
Bugün ise daha zor bir soru sormamız gerekiyor:
“Bu katılımcının bize anlattığı gerçek mi?”
Insights Association, H1 2026 Global Data Quality Benchmarking Report. Insights Association
Insights Association, Data Quality and Standards. Insights Association
Insights Association, Transparency in the Fight Against Survey Fraud, 2026. Insights Association
Insights Association, Sample Supply Transparency Framework, 2026. Insights Association
ESOMAR/GRBN, Guideline on Online Sample Quality. shop.esomar.org
Pew Research Center, Can AI Stand In for Human Survey-Takers? Not Really, 2026. Pew Research Center
Pew Research Center, What Are Bogus Respondents?, 2026.